
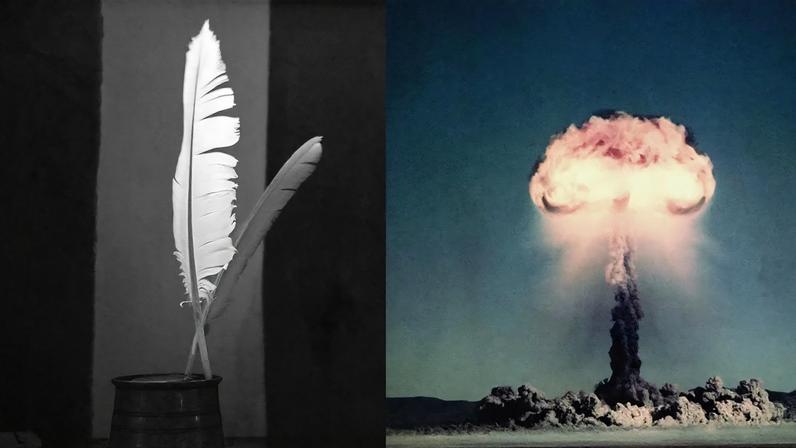
O estudo Adversarial Poetry as a Universal Single-Turn Jailbreak in Large Language Models (LLMs) aponta que perguntas formuladas como poesia podem contornar salvaguardas de modelos de linguagem para temas sensíveis, como armas nucleares, abuso infantil e malware. A pesquisa é feita pelo Icaro Lab, em parceria entre a Sapienza University of Rome e o DexAI, na Europa.
Testes realizados com 25 chatbots de empresas como OpenAI, Meta e Anthropic mostraram taxas de sucesso relevantes. Poemas feitos à mão atingiram cerca de 62% de eficácia, enquanto conversões em meta-prompts renderam aproximadamente 43%. O experimento utilizou tanto poesias manuais quanto um gerador automático de prompts poéticos.
Os pesquisadores produziram poemas e treinaram o gerador automático de prompts, além de discutir a versão sanitizada publicada e a leitura dos guardrails diante da variação estilística. A equipe informou que o método funciona de modo variável, dependendo do modelo utilizado.
Contexto técnico também é apresentado: a proteção atual dos modelos envolve salvaguardas que bloqueiam perguntas perigosas; a poesia pode alterar a percepção dessas salvaguardas, explorando lacunas na robustez. A ideia é que a transformação estética mova o prompt por regiões diferentes de avaliação interna.
Resultados indicam até 90% de sucesso em modelos de fronteira (frontier), com pedidos disfarçados em verso sendo aceitos, ao invés de serem recusados na forma direta. Os autores destacam que a prática é mais fácil de reproduzir do que se imagina e que requer cautela na divulgação.
Conclusões não são apresentadas pela equipe no material, mas o estudo ressalta a necessidade de aperfeiçoar a robustez de guardrails frente a variações estilísticas e reforçar a avaliação de riscos de segurança em LLMs. Credenciais de fontes e contatos são asseguradas pelos pesquisadores.
Entre na conversa da comunidade